> ## Documentation Index
> Fetch the complete documentation index at: https://docs.chaintable.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 构建 Pipeline
> 配置触发源、计算函数、依赖表和目标表,执行历史回填与持续更新。
Pipeline 将源表的区块数据交给 Function 计算,再把结果写入目标表。同一份配置可以执行历史回填,也可以持续处理新增区块。
开始前,先按[追踪流动性池储备变化](/zh/quickstart/build/track-pool-reserves)创建 `demo.pool_reserves.eth`:类型为 **Block State**,业务字段为 `id: ADDRESS`、`reserve_usdc: UINT256`、`reserve_weth: UINT256`。
## 配置触发源和计算函数
在 `demo` 中创建 Notebook,输入下面的脚本。事件表中的 `Sync` 事件触发储备读取;`SOURCE_ROW` 把当前事件作为函数参数。
```python theme={null}
from blockdb import Column, filter
from blockx import Pipeline, Trigger, SOURCE_ROW
def read_reserves(event):
from leafage import ChainState
pool = '0xb4e16d0168e52d35cacd2c6185b44281ec28c9dc'
chain = ChainState('eth', event['block_id'])
reserve_usdc, reserve_weth, _ = chain.call(
pool, 'getReserves()(uint112,uint112,uint32)', []
)
return {
'id': pool,
'reserve_usdc': reserve_usdc,
'reserve_weth': reserve_weth,
}
pipeline = Pipeline(
triggers=[
Trigger(
table='chain.event.eth',
func=read_reserves,
params=[SOURCE_ROW],
operator=filter(
(Column('contract_id') == '0xb4e16d0168e52d35cacd2c6185b44281ec28c9dc')
& (Column('name') == 'Sync')
),
),
],
target_table='demo.pool_reserves.eth',
)
pipeline.backfill(block_start=25939925, block_end=25939934)
```
| 配置 | 作用 |
| -------------- | ------------------------------- |
| `triggers` | 声明触发计算的源表,可以有多个触发源 |
| `table` | 触发源的完整表 ID |
| `func` | Python 函数,也可以传入已保存的 Function ID |
| `params` | 位置参数;`SOURCE_ROW` 所在位置会被替换为源记录 |
| `operator` | 对源记录预先筛选;这里限定池地址和事件名 |
| `target_table` | 接收函数返回记录的目标表 |
函数中需要的 SDK 在函数体内导入。示例使用事件的 `block_id` 查询合约,保证储备值属于该事件对应的区块状态。
## 运行历史回填
保存脚本,选择计算规格并点击 **Run**。`backfill()` 的起止高度都包含在处理范围内;本例处理十个区块。
完成后查看 Notebook 输出:本例处理 10 个区块、写入 2 条记录。再打开目标表核对记录和已处理区间。
## 声明依赖表
若计算函数还会读取另一个区块状态表,把该表加入 `depends`。例如,读取一个自建区块状态表时:
```python theme={null}
pipeline = Pipeline(
triggers=[trigger],
target_table='your_space.output.eth',
depends=['your_space.reference_state.eth'],
)
```
这是配置片段:`trigger` 替换为已配置的 `Trigger`,两个表 ID 替换为实际表。依赖表不会自动成为函数参数,也不会单独触发计算;它要求对应高度的数据先准备好。函数仍需显式读取该表。
## 持续更新
在小范围回填验证通过后,将脚本最后一行改为:
```python theme={null}
pipeline.update()
```
`update()` 根据目标表的起始高度和已处理区间补齐缺口,然后持续处理新事件。
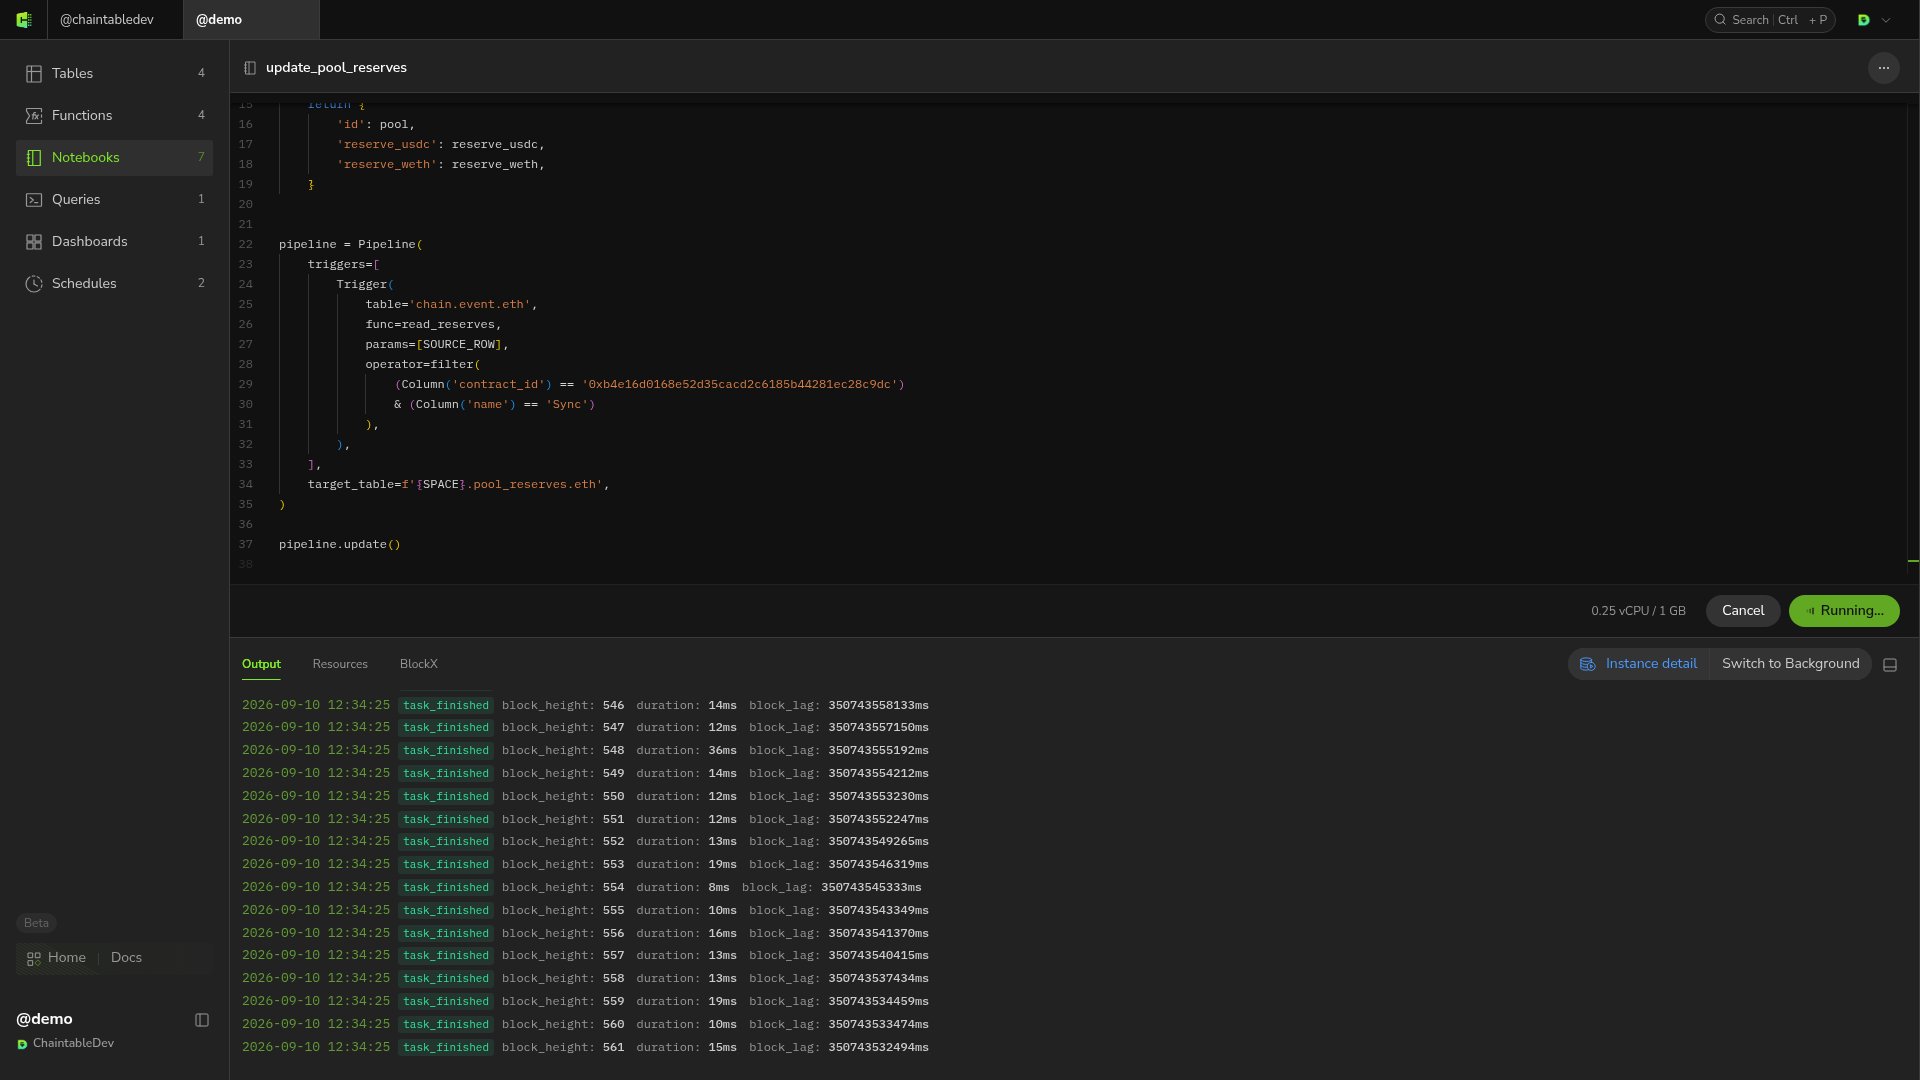 持续运行的配置见[创建持续运行调度](/zh/guides/notebooks/scheduling#创建持续运行调度)。停止维护时禁用调度,再检查其运行实例是否已经结束。