> ## Documentation Index
> Fetch the complete documentation index at: https://docs.chaintable.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 读写数据
> 使用 BlockDB SDK 按主键、区块和时间读写不同类型的数据表。
以下代码在 Chaintable Notebook 中运行。开始前,先按[创建和管理表](/zh/guides/tables/create-and-manage)创建目标表;示例中的 `demo` 替换为你的 Space ID。
根据表类型选择 `NormalTable`、`EventTable`、`StateTable` 或 `TimeTable`,构造对象时指定完整表 ID。
## 普通表:写入和更新
下面的 `demo.asset_notes` 使用 `id: STRING`、`symbol: STRING`、`amount: UINT256`。
```python theme={null}
from blockdb import NormalTable
notes = NormalTable('demo.asset_notes')
notes.write([{'id': 'usdc', 'symbol': 'USDC', 'amount': 1500000}])
```
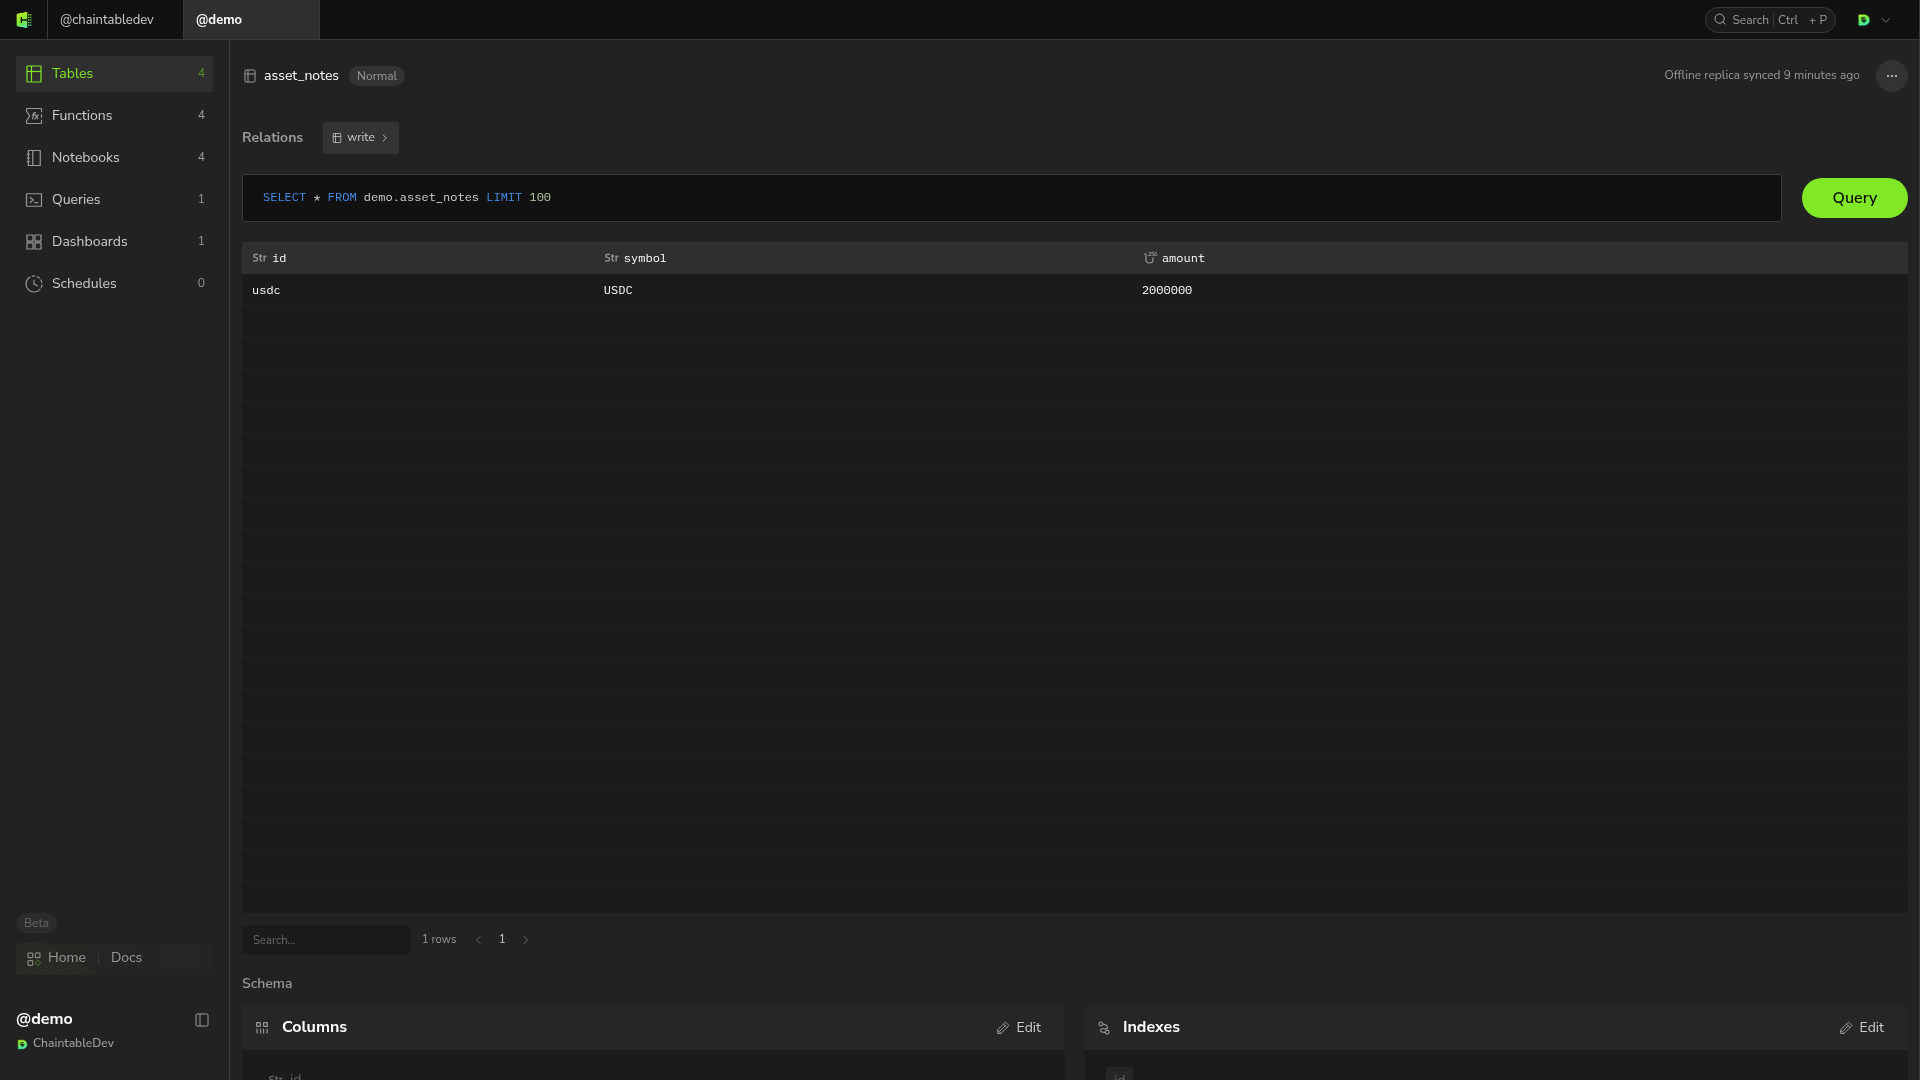
再次写入同一 `id`,更新该记录:
```python theme={null}
notes.write([{'id': 'usdc', 'symbol': 'USDC', 'amount': 2000000}])
```
`write()` 返回 `True` 表示请求已被接受,数据可能稍后才可见。写入后可用以下方法读取:
```python theme={null}
print(notes.get('usdc'))
print(notes.get_many(['usdc']))
print(notes.filter_rows("id = 'usdc'", limit=5))
```
`get()` 查不到记录时返回 `None`。`get_many()` 按输入 ID 的顺序返回结果,缺失位置为 `None`。`filter_rows()` 接收 SQL 条件字符串,不传 `WHERE` 关键字。
 使用 `notes.delete(['要删除的记录ID'])` 删除普通表记录。
## 区块表:读取当前状态和区块记录
区块事件使用 `EventTable`,区块状态使用 `StateTable`。下面读取[追踪流动性池储备变化](/zh/quickstart/build/track-pool-reserves)中已构建的状态:
```python theme={null}
from blockdb import StateTable
reserves = StateTable('demo.pool_reserves.eth')
row = reserves.get('0xb4e16d0168e52d35cacd2c6185b44281ec28c9dc')
print(row)
```
这里省略 `block_id`,`StateTable.get()` 直接读取该对象的 latest,不按共识高度限制读取位置。读到最新状态不代表此前的区块已全部处理。
要读取指定区块时的状态,使用 `StateTable(table_id, block_id)`。目标区块须在表的共识高度内,否则查询会被拒绝,详见[工作原理](/zh/guides/tables/model#区块数据与处理进度)。
需要一个区块内写入的全部记录时,使用 `get_block_rows()`:
```python theme={null}
from blockdb import Block
block = Block(
id='0x147dd9f92835784656144336c9a1ae3e9bed659e8d5fb75516c9a956a0eb3c14',
height=25939930,
timestamp='2026-09-09T12:51:35Z',
)
print(reserves.get_block_rows(block))
```
事件表按事件 ID 读取时使用相同的 `get()` / `get_many()` 形式,构造对象改为 `EventTable(table_id, block_id)`。
## 区块表:提交一个区块
写入时传入结果行和区块 ID。服务端补齐 `block_height`、`block_id` 和 `block_timestamp`。
```python theme={null}
from blockdb import StateTable
StateTable('demo.pool_reserves.eth').write(
[{
'id': '0xb4e16d0168e52d35cacd2c6185b44281ec28c9dc',
'reserve_usdc': '10126490434274',
'reserve_weth': '4043982044925209426729',
}],
'0x147dd9f92835784656144336c9a1ae3e9bed659e8d5fb75516c9a956a0eb3c14',
)
```
一条结果也没有的已处理区块应提交空列表,使区块进度可以继续推进。通常让 [Pipeline](/zh/guides/notebooks/build-pipeline) 完成提交和结果写入。
## 时间表:按时刻读写
`demo.price_samples` 使用时间表的固定字段 `id`、`time_at`、`value`,其中 `id` 为 `STRING`。
```python theme={null}
from blockdb import TimeTable
prices = TimeTable('demo.price_samples')
prices.write([{'id': 'usdc', 'value': 1.0}], '2026-09-09T12:00:00Z')
```
数据可见后,分别读取指定时刻和最新值:
```python theme={null}
print(TimeTable('demo.price_samples', '2026-09-09T12:00:00Z').get('usdc'))
print(TimeTable('demo.price_samples').get('usdc'))
```
时间参数可以使用带时区的 RFC3339 字符串;无时区时间按 UTC 处理。服务端负责时间分桶,传入原始采样时间即可。
## 大批量写入
数据量超出单次请求上限时使用 `batch_write()`。三类表的调用方式不同:
| 表类型 | 调用 | 每行必须携带 |
| --- | ------------------------------ | ------------------------------------------------- |
| 普通表 | `batch_write(rows)` | 相同的字段集合 |
| 时间表 | `batch_write(rows)` | 自己的 `time_at` |
| 区块表 | `batch_write(rows, bundle_id)` | 自己的 `block_id`、`block_height` 和 `block_timestamp` |
区块表按[区块包](/zh/guides/tables/model)提交,一次覆盖该区块包已有的全部数据。逐块写入时由服务端补齐的三个区块字段,这里必须每行自带;缺少任何一个,整个任务都会失败。
批量写入异步执行,返回 `True` 只表示已提交。提交后的状态检查见[查看异步写任务](/zh/guides/tables/advanced#查看异步写任务)。